Generate Embedding
Generate Embedding 是用於將文字內容轉換為向量表示的 processor。
基本用法
執行 Generate Embedding 時,會使用指定的 Embedding Model 將輸入文字轉換為數值向量,這些向量可用於語意搜尋、相似度計算、文件分類等需要向量化處理的場景。生成的向量會以浮點數陣列形式儲存到指定變數中供後續 processor 使用。
配置參數
節點的屬性面板:
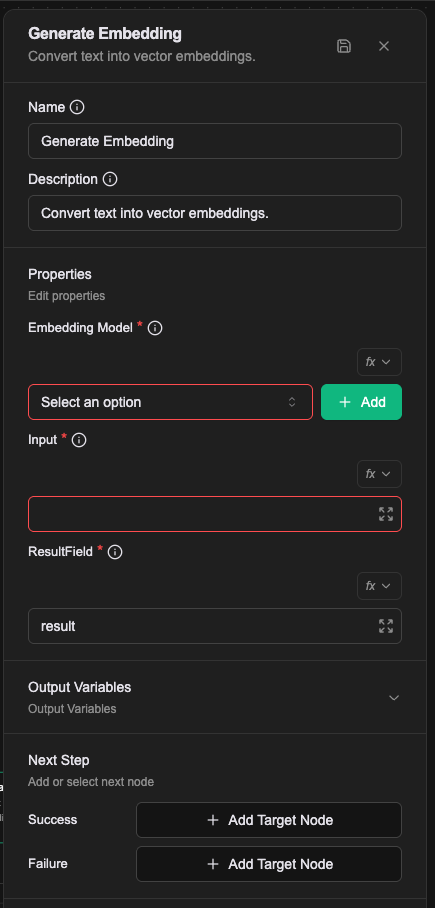
Name
顯示在畫布上的名稱,用於在工作流程中識別此 processor。
Description
用於補充此 processor 的用途,提升工作流程的可讀性。
Properties
Embedding Model(必填)
選擇要使用的 Embedding Model 資源名稱。需要先建立 Embedding Model 資源,支援各種預訓練的 Embedding 模型,如 OpenAI text-embedding 系列等。
Input(必填)
要轉換為向量的輸入內容。支援 Literal、Expression、Template 等設定類型,詳細說明請參考:Expression 介紹 - 取值方式。
Result Field(必填)
向量化結果要儲存的變數名稱,查詢結果(浮點數陣列)會儲存到此變數名稱對應的 context payload 欄位中。
在 Workflow CRD 中的設定
- name: proc-embed
  type: generate-embedding
  labels:
    display_name: 向量化使用者提問
  configs:
    - name: embeddingModel
      value: em-builtin
    - name: input
      expression: prevMessage
    - name: resultField
      value: result
resultField 的預設值是 result,其餘兩個沒有預設值,必須自行填入。
連接關係
Success
當成功生成文字向量時,工作流程會從此連接點繼續執行。向量化結果會以浮點數陣列形式儲存到 Result Field 指定的變數名稱中,該變數可供後續 processor 使用。
Failure
當向量化過程發生錯誤時,工作流程會從此連接點繼續執行,並產生 prevError 變數儲存錯誤資訊。
一個實際的例子
把使用者輸入轉成向量,接著拿去查知識庫。
| 欄位 | 值 |
|---|---|
| Embedding Model | 專案裡設定好的 Embedding Model |
| Input | Expression:prevMessage |
| ResultField | query_vector |
執行後 query_vector 是一個數字陣列(Array[Number])。變數名稱由 ResultField 決定,預設是 result。
注意事項
- 不同的 Embedding Model 產生的向量維度不同,換模型之後舊向量不能拿來跟新向量比對。
- 向量只有跟同一個模型產生的向量比較才有意義。
- 模型有輸入長度上限,長文要自己先切段。