Retrieve Knowledge
Retrieve Knowledge 是用於從知識庫中檢索相關資料的 processor。
基本用法
執行 Retrieve Knowledge 時,會使用設定的查詢文字在指定的知識庫中進行語意搜尋,根據相似度閾值篩選結果,並將符合條件的資料以陣列形式儲存到指定變數中供後續 processor 使用。適用於智能問答、文件檢索、內容推薦、客服支援等需要基於知識庫提供精準資訊的場景。
配置參數
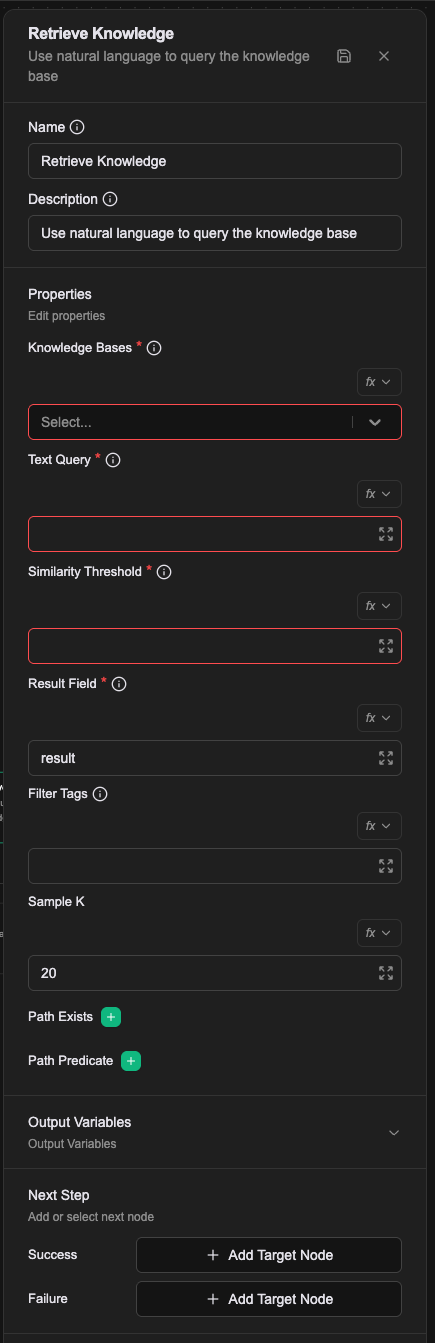
節點的屬性面板:
Name
顯示在畫布上的名稱,用於在工作流程中識別此 processor。
Description
用於補充此 processor 的用途,提升工作流程的可讀性。
Properties
Knowledge Bases(必填)
選擇要檢索的知識庫名稱,以逗號分隔的 KnowledgeBase 名稱清單。可選擇多個知識庫進行跨庫檢索。需要先建立並匯入知識庫資料。
Text Query(必填)
用於檢索的文字查詢內容。支援 Literal、Expression、Template 等設定類型,詳細說明請參考:Expression 介紹 - 取值方式。
Similarity Threshold(必填)
相似度閾值,用於篩選檢索結果。範圍為 0-1 之間的數值,1 表示最相似,數值越小相似度要求越低。一般設定在 0.1-0.7 之間。
Result Field(必填)
檢索結果要儲存的變數名稱,檢索結果會以陣列形式儲存到此變數中,預設值為 result。
Filter Tags
用於篩選結果的標籤,以逗號分隔的標籤清單。可根據知識庫中的標籤進行額外篩選。
Sample K
從索引資料及其增強資料中取樣的數量,預設值為 20。控制檢索過程中的取樣範圍。
Path Exists
檢查指定 JSON 路徑的欄位是否存在。使用有效的 JSON Path 語法,用於過濾具有特定欄位結構的資料。可設定多個路徑檢查條件。
想了解更多 JSON Path 語法的表達方式,請參考 JSONPath 語法規範。
Path Predicate
使用 JSON Path 述詞進行條件篩選。格式為有效的 JSON Path 述詞(例如:$.category == "HR"),多個述詞之間使用 AND 邏輯連接。可設定多個篩選條件。
在 Workflow CRD 中的設定
- name: proc-retrieve
  type: retrieve-knowledge
  labels:
    display_name: 檢索產品知識庫
  configs:
    - name: knowledgeBases
      value: kb-product-manual,kb-faq
    - name: textQuery
      expression: prevMessage
    - name: similarityThreshold
      value: "0.7"
    - name: resultField
      value: result
    - name: sampleK
      value: "20"
    - name: filterTags
      value: public
knowledgeBases 與 filterTags 都是以逗號分隔的字串,不是陣列。resultField 的預設值是 result,sampleK 的預設值是 20。
這個 processor 允許動態設定,編輯器上的 Path Exists 與 Path Predicate 就是以動態設定的形式加上去的。
連接關係
Success
當成功檢索到結果時,工作流程會從此連接點繼續執行。檢索結果會以陣列形式儲存到 Result Field 指定的變數名稱中,該變數可供後續 processor 使用。
Failure
當檢索過程發生錯誤時,工作流程會從此連接點繼續執行,並產生 prevError 變數儲存錯誤資訊。
一個實際的例子
用使用者的問題去查知識庫。
| 欄位 | 值 |
|---|---|
| Knowledge Bases | 專案裡的知識庫(可複選) |
| Text Query | Expression:prevMessage |
| Similarity Threshold | 0.7 |
| Result Field | kb_hits |
| Sample K | 5 |
執行後 kb_hits 是一個物件。變數名稱由 Result Field 決定,預設是 result。後面通常接 LLM Completion,把命中的片段放進 Prompt 一起送給模型。
注意事項
- Similarity Threshold 是必填,決定回傳哪些片段;調高會漏、調低會雜,要看知識庫內容調。
- Sample K 決定最多回幾筆。
- Filter Tags 用來限制只在帶特定標籤的文件裡找。