Stream LLM Completion
Stream LLM Completion 是用於呼叫大型語言模型並產生串流式自然語言輸出的 processor。
基本用法
執行 Stream LLM Completion 時,會將設定的 Prompt 發送給指定的 Completion Model,模型會即時產生回應並以「逐字輸出」的方式呈現,模擬真人打字效果。此 processor 已內建訊息輸出功能,無需額外連接 Push Message。適用於需要自然對話體驗的 AI 聊天機器人、即時客服回應、互動式問答等場景。
配置參數
節點的屬性面板:
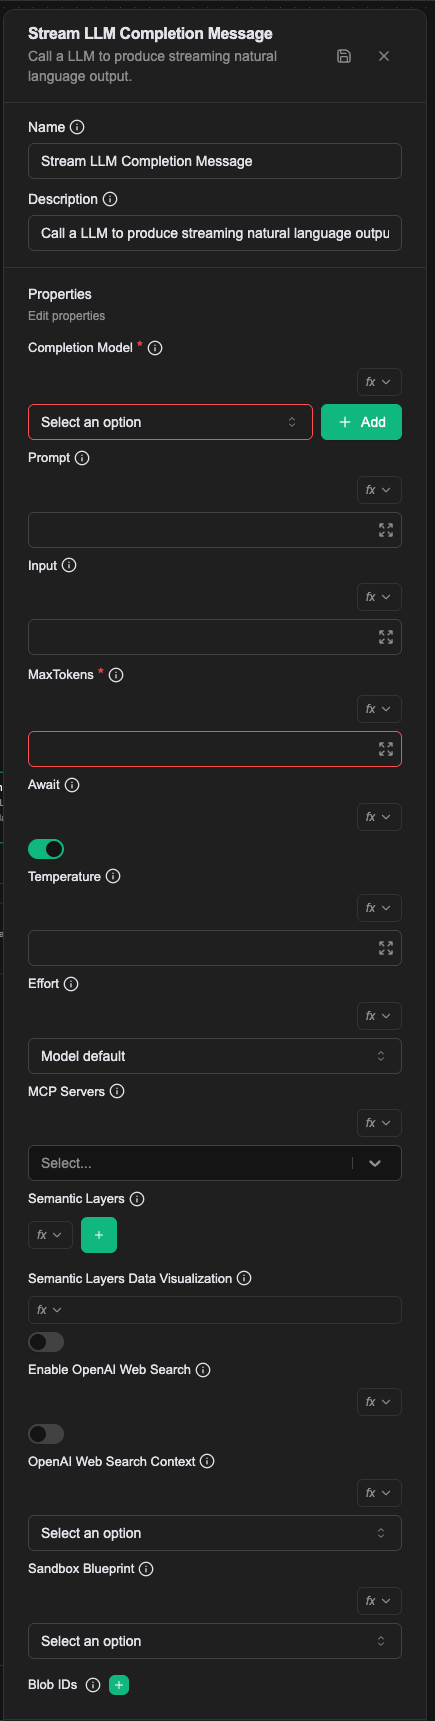
Name
顯示在畫布上的名稱,用於在工作流程中識別此 processor。
Description
用於補充此 processor 的用途,提升工作流程的可讀性。
Properties
Completion Model(必填)
選擇要使用的 Completion Model 資源名稱。需要先建立 Completion Model 資源,支援 OpenAI GPT、Claude、Gemini 等模型。
Prompt(必填)
發送給 AI 模型的提示詞,用於提供資料補充背景和必要的記憶。
設定類型
- Literal:直接輸入固定提示內容
- Expression:使用 JavaScript 表達式動態產生提示
- Template:使用模板語法和內建函數組合提示內容
詳細的取值方式說明請參考:Expression 介紹 - 取值方式
Input
這一回合要送給模型的使用者訊息。留空時,processor 會改用管道傳進來的訊息,也就是 context 中的 prevMessage。
一般對話流程不需要設定這個欄位,讓它沿用使用者實際說的話即可。需要覆寫的情境通常是先對輸入做過加工,例如補上前文摘要或改寫成更明確的問句之後,再交給模型。
MaxTokens(必填)
設定模型提示 + 生成回應的最大 Token 數量,用於控制回應長度和成本。
Await
控制工作流程是否等待 LLM 完全輸出完成後才繼續執行。開啟時等待完整回應生成,關閉時模型開始輸出第一個 Token 就繼續執行。
Temperature
(可選) 模型的溫度值,控制回答的隨機性。數值越高,回答越隨機多樣;數值越低,回答越確定一致。數值範圍限制隨著使用的 completion model 會有所不同,需依照該模型的限制填入。省略時會自動採用模型的預設值。注意:某些模型不支援溫度值參數,請勿在此類模型中設定此欄位。
Effort
推理強度,可設為 low、medium、high、xhigh、max,或 auto 表示交給模型自行決定。它同時控制思考深度與整體 token 花費。
未設定時採用模型預設值。並非每個模型都支援每一個等級,送出不支援的等級會讓該回合失敗;有些模型(特別是速度取向的 Haiku 等級)根本不接受這個參數,這種情況要設為 disabled,讓系統完全不送出這個欄位。
MCP Servers
(可選) 模型可以使用的 toolset 名稱,可從下拉選單選擇。當有設定 toolsets 時,會賦予模型調用這些工具集之下的所有工具。多數情況下,為了使模型更清楚何時該正確的調用何種工具,建議也要於 prompt 處進行向模型相關的調用說明。
Enable OpenAI Web Search
(可選) 是否啟用 OpenAI Web Search 功能。僅限支援 Web Search 的 OpenAI 模型使用。啟用後,模型可搜尋網路資訊來回答問題。(詳細資訊可參考:OpenAI 官方文件)
OpenAI Web Search Context
(可選) 控制從網路檢索多少內容來協助工具產生回應。可選值:'low'(低)、'medium'(中)、'high'(高)。只有在啟用「Enable OpenAI Web Search」設定時,才可以進一步設定此設定值。
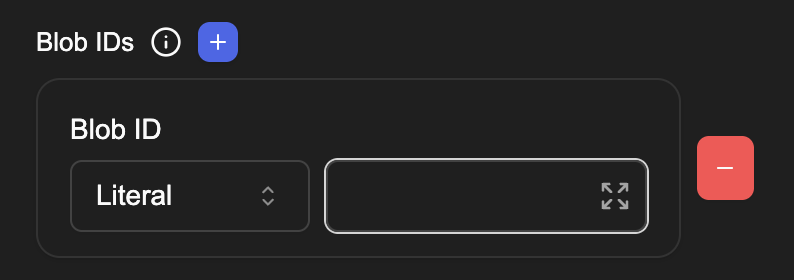
Blob IDs
提供給模型分析的圖片或檔案 ID,可點擊 (+) 按鈕後新增多筆 Blob ID 資料。僅在使用支援視覺解析功能的 Completion Model 時可用。模型會根據這些內容進行分析並回應。
Semantic Layers
以 JSON 陣列設定要掛給模型的語意模型,每個元素的形狀為:
[
  {
    "name": "<CR name>",
    "allowQuery": true,
    "allowWrite": false,
    "allowedCubes": ["orders", "order_items"]
  }
]
和底下單數形的 Semantic Layer 相比,這個欄位可以一次掛上多個語意模型,讓同一次 LLM 呼叫跨多個資料庫查詢。新的工作流程請使用這個欄位。
Semantic Layers Data Visualization
預設關閉。開啟後,只要至少設定了一個語意模型,模型就會額外獲得兩個工具:show_result_set_table 與 show_vega_visualization,用來把最近一次查詢結果轉成 UI 表格或 Vega v5 圖表。
這是選擇性開啟的功能。沒有開啟時,查詢結果只會以文字形式回覆。
Sandbox Blueprint
指定一個 SandboxBlueprint 名稱,為這次 LLM 呼叫建立對應的 Sandbox。設定後系統會先確保 Sandbox 進入 Ready 狀態才送出任務,模型則會取得綁定該 Sandbox 的內建工具(bash、str_replace_editor),以及在 system prompt 中被探索到的 Skills。
留空表示這次呼叫不掛載 Sandbox。
在 Workflow CRD 中的設定
- name: proc-agent-stream-msg
  type: stream-llm-completion-message
  labels:
    display_name: Agent
    description: 電商總管主回應
  configs:
    - name: completionModel
      value: cm-builtin-balanced
    - name: prompt
      template: |
        你是電商總管,一個協助電商營運團隊的 AI 協作 Agent。
        {{#if prevPayload.brand}}
        目前處理的品牌是 {{{prevPayload.brand.display_name}}}。
        {{/if}}
    - name: maxTokens
      value: "60000"
    - name: await
      value: "true"
    - name: toolsets
      value: "ts-ui-event"
    - name: sandboxBlueprint
      value: "sbp-ec-manager"
prompt 是跨回合穩定的系統提示與人設,不放使用者訊息或對話歷史,那是 input 的職責。用 template 撰寫時可使用 Handlebars 的條件式,依 payload 內容組出不同的人設。
toolsets 是編輯器上顯示為 MCP Servers 的那個欄位,值是以逗號分隔的 Toolset 名稱。
連接關係
Success
- Await 模式:當 AI 模型完全生成完整回應後,工作流程會從此連接點繼續執行
- Non-Await 模式:當 AI 模型開始生成第一個 Token 時,工作流程立即從此連接點繼續執行
Failure
當 AI 模型呼叫失敗時,工作流程會從此連接點繼續執行,並產生 prevError 變數儲存錯誤資訊。
一個實際的例子
一般的對話回覆:接在 Listen Message 後面,把使用者說的話丟給模型,回覆直接串流出去。
| 欄位 | 值 |
|---|---|
| Completion Model | 專案裡設定好的模型 |
| Prompt | 系統提示,例如 你是客服助理,回答要簡短。 |
| Input | Expression:prevMessage |
| MaxTokens | 1024 |
| Await | 關閉 |
Await 關閉時流程送出回覆就往下走;需要在回覆結束後再做事(例如記錄到資料庫)才開啟它。
注意事項
- 這個 processor 自己就會把回覆送給使用者,後面不需要再接 Push Message。
- 回覆是逐字串流出去的,不是等整段生成完才出現。
Await決定要不要等整段回覆結束再往下走:開啟時後面的節點拿得到完整回覆,關閉時流程會先繼續跑。