Generate Embedding
Generate Embedding はテキストをベクトル表現に変換するプロセッサーです。
基本的な使い方
Generate Embedding は指定した Embedding Model を使い、入力テキストを数値ベクトルに変換します。意味検索、類似度の計算、文書分類など、ベクトル化が必要な場面で使います。結果は浮動小数点数の配列として指定の変数に保存され、後続のプロセッサーで利用できます。
設定項目
ノードのプロパティパネルです。
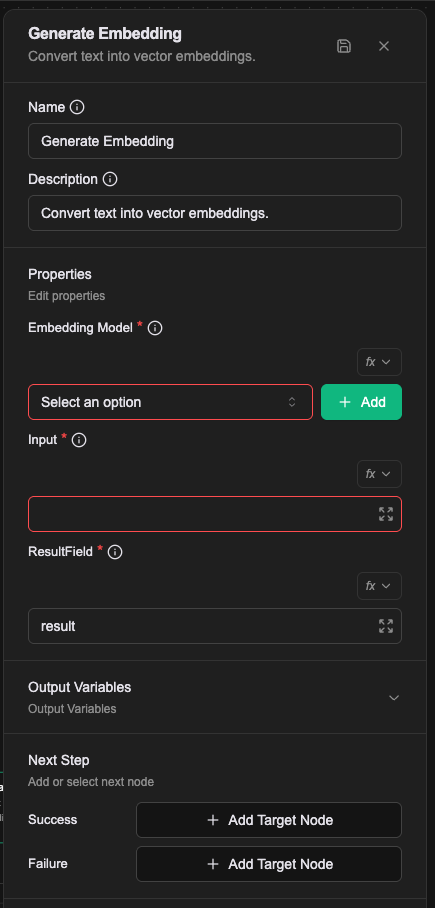
Name
キャンバス上に表示される名前です。ワークフロー内でこのプロセッサーを識別するために使います。
Description
このプロセッサーの用途を補足し、ワークフローの読みやすさを高めます。
Properties
Embedding Model(必須)
使用する Embedding Model リソースの名前です。あらかじめリソースを作成しておく必要があります。OpenAI の text-embedding 系をはじめ、さまざまな学習済みモデルに対応しています。
Input(必須)
ベクトルに変換する入力内容です。Literal、Expression、Template の値の種類に対応しています。詳しくはExpression の概要 — 値の取得を参照してください。
Result Field(必須)
ベクトルを受け取る変数の名前です。結果である浮動小数点数の配列が、その名前の context payload 項目に保存されます。
Workflow CRD での設定
- name: proc-embed
  type: generate-embedding
  labels:
    display_name: ユーザーの質問をベクトル化
  configs:
    - name: embeddingModel
      value: em-builtin
    - name: input
      expression: prevMessage
    - name: resultField
      value: result
resultField の既定値は result です。残る 2 つに既定値はなく、必ず指定します。
接続関係
Success
ベクトルの生成に成功すると、この接続点から次へ進みます。結果は浮動小数点数の配列として Result Field の変数に保存され、後続のプロセッサーで利用できます。
Failure
変換の途中でエラーが起きた場合、この接続点から続き、prevError 変数にエラー情報が入ります。
実際の例
ユーザーの入力をベクトルにして、ナレッジベース検索に使います。
| 項目 | 値 |
|---|---|
| Embedding Model | プロジェクトに設定済みの Embedding Model |
| Input | Expression:prevMessage |
| ResultField | query_vector |
実行後、query_vector には数値の配列(Array[Number])が入ります。変数名は ResultField で決まり、既定は result です。
注意事項
- Embedding Model が違えばベクトルの次元も違うため、モデル変更の前後で作ったベクトルは比較できません。
- ベクトルは同じモデルで作られたベクトルとだけ比較して意味があります。
- モデルには入力長の上限があるので、長文は事前に分割が必要です。