Retrieve Knowledge
Retrieve Knowledge はナレッジベースから関連する情報を検索するプロセッサーです。
基本的な使い方
Retrieve Knowledge は指定したナレッジベースに対して、クエリ文で意味検索を行い、類似度のしきい値で結果を絞り込み、該当したものを配列として指定の変数に保存します。後続のプロセッサーがそれを利用できます。質問応答、文書検索、コンテンツの推薦、サポートなど、ナレッジベースに基づく正確な情報が必要な場面で使います。
設定項目
ノードのプロパティパネルです。
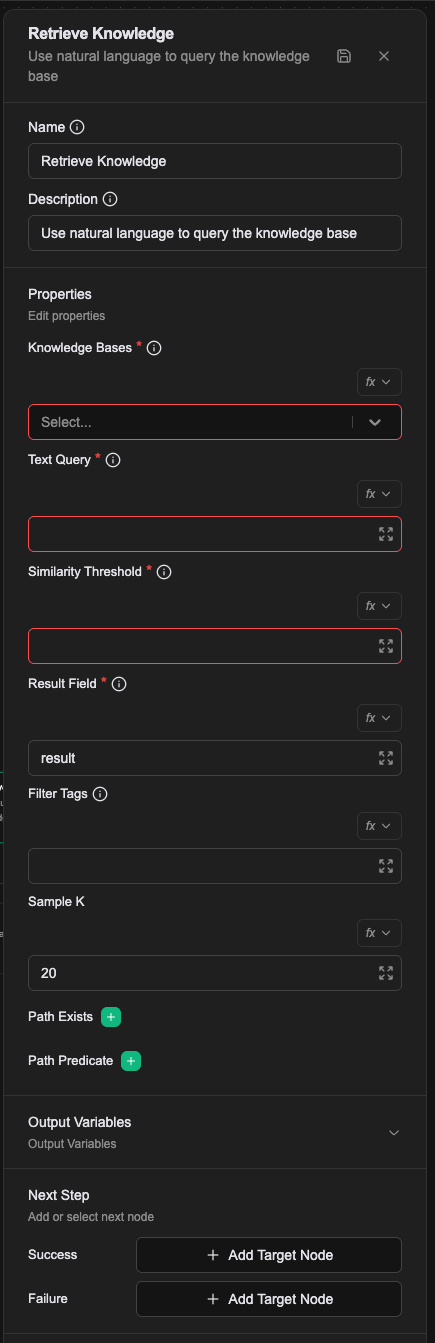
Name
キャンバス上に表示される名前です。ワークフロー内でこのプロセッサーを識別するために使います。
Description
このプロセッサーの用途を補足し、ワークフローの読みやすさを高めます。
Properties
Knowledge Bases(必須)
検索対象のナレッジベース名を、カンマ区切りの一覧で指定します。複数を同時に検索できます。あらかじめナレッジベースを作成し、データを取り込んでおく必要があります。
Text Query(必須)
検索に使うテキストです。Literal、Expression、Template の値の種類に対応しています。詳しくはExpression の概要 — 値の取得を参照してください。
Similarity Threshold(必須)
結果を絞り込むための類似度のしきい値で、0 から 1 の範囲です。1 が最も類似しており、値が小さいほど条件が緩くなります。一般には 0.1 から 0.7 の間に設定します。
Result Field(必須)
結果を受け取る変数の名前です。結果は配列として保存されます。既定値は result です。
Filter Tags
結果を絞り込むタグを、カンマ区切りの一覧で指定します。ナレッジベース側のタグを使ってさらに絞り込みます。
Sample K
索引データとその拡張データから抽出する件数です。既定値は 20 で、検索時のサンプリングの広さを制御します。
Path Exists
指定した JSON パスの項目が存在するかを確認します。妥当な JSON Path 構文を受け取り、特定の構造を持つデータだけを通します。複数の条件を設定できます。
JSON Path の構文については JSONPath の仕様を参照してください。
Path Predicate
JSON Path の述語で条件を絞り込みます。妥当な述語構文(たとえば $.category == "HR")を指定し、複数の述語は AND で結合されます。
Workflow CRD での設定
- name: proc-retrieve
  type: retrieve-knowledge
  labels:
    display_name: 製品ナレッジベースを検索
  configs:
    - name: knowledgeBases
      value: kb-product-manual,kb-faq
    - name: textQuery
      expression: prevMessage
    - name: similarityThreshold
      value: "0.7"
    - name: resultField
      value: result
    - name: sampleK
      value: "20"
    - name: filterTags
      value: public
knowledgeBases と filterTags はいずれもカンマ区切りの文字列で、配列ではありません。resultField の既定値は result、sampleK の既定値は 20 です。
このプロセッサーは動的な設定に対応しており、エディター上の Path Exists と Path Predicate は動的設定として追加されています。
接続関係
Success
検索に成功すると、この接続点から次へ進みます。結果は配列として Result Field の変数に保存され、後続のプロセッサーで利用できます。
Failure
検索の途中でエラーが起きた場合、この接続点から続き、prevError 変数にエラー情報が入ります。
実際の例
ユーザーの質問文でナレッジベースを検索します。
| 項目 | 値 |
|---|---|
| Knowledge Bases | プロジェクトのナレッジベース(複数選択可) |
| Text Query | Expression:prevMessage |
| Similarity Threshold | 0.7 |
| Result Field | kb_hits |
| Sample K | 5 |
実行後、kb_hits にはオブジェクトが入ります。変数名は Result Field で決まり、既定は result です。後ろには通常 LLM Completion を置き、ヒットした断片を Prompt に含めます。
注意事項
- Similarity Threshold は必須で、どの断片を返すかを決めます。高すぎると取りこぼし、低すぎるとノイズが混ざるため、ナレッジベースの中身に合わせて調整します。
- Sample K は返す件数の上限です。
- Filter Tags は特定のタグを持つ文書だけに検索を限定します。